openLLM(KoAlpaca)에 제주도 사투리 학습
in LLM
내용 요약: openLLM 중 KoAlpaca에 제주도 사투리를 학습시켜서 표준어로 번역해주는 fine-tuning을 진행한다
KoAlpaca는 한국어 명령을 이해하는데 적한한 오픈소스 언어모델로, 앞글자인 ‘Ko’ 라는 것만 봐도 대충 한국어에 적합한 언어모델인 것을 유추할 수 있습니다. 때문에 한국어 텍스트를 효율적으로 처리하고 이해하는 데 최적화되어 있으며, 다양한 한국어 자연어 처리 작업에서 사용될 수 있습니다. 한국어의 다양한 어휘와 문법 구조를 이해하고 처리할 수 있는 능력을 갖추고 있고 한국어 데이터에 특화된 처리 능력을 가지고 있습니다!!
https://github.com/Beomi/KoAlpaca
1. 데이터 전처리
AIhub에서 사투리와 관련된 자료를 다운받았다.
샘플 데이터를 받아 어떤 형태로 되어 있는 보면 자료 수집시 녹음을 진행했던 것 같다. 파일을 살펴보면 사투리가 시작된 부분부터 해서 녹음의 시간이 start, end로 표시되어 있는 것을 알 수 있었다.
하지만 우리가 사용할 것은 사투리(질문에 사용): dialect, 표준어(답변에 사용): standard 만 있으면 된다!
다운로드 받은 json 파일을 열어서 어떻게 작성되어 있는지 자세히 살펴보면
"transcription": {
	...
	"sentences": [
		"dialect": "~~~",
		"standard": "~~~~"
		...
‘transcription’ 키 값 안에 “sentences” 안에 우리가 학습에 사용하고 싶은 “dialect”, “standard” 가 들어있는 것을 확인할 수있다
우리는 이것을 활용한다! 
위에서 알아낸 사실을 이용해서 AIhub에서 다운로드 받은 데이터에서 필요한 dialect, standard만 뽑아내는 python 코드를 작성한다
코드 요약:
필요한 json 파일들을 한번에 읽어오기
‘transcription’ 안에 “sentences” 안에 필요한 것이 있다
필요한 것만 모아서 다시 json 파일로 저장
import json
import os

print('실행')

# 데이터가 있는 디렉토리 경로
data_directory = 'json데이터가 있는 폴더 경로'

# dialect(사투리)와 standard(표준어)만 누적하여 저장할 변수
combined_data = []

# 디렉토리 경로의 모든 JSON 파일을 읽어서 dialect와 standard만 추출하여 하나의 변수에 누적하여 저장
for filename in os.listdir(data_directory):
    if filename.endswith('.json'):
        with open(os.path.join(data_directory, filename), 'r', encoding='utf-8', errors='ignore') as file:
            data = json.load(file)
            for sentence in data['transcription']['sentences']:
                combined_data.append({'dialect': sentence['dialect'], 'standard': sentence['standard']})

# 새로운 JSON 파일에 저장
with open('data_processing1.json', 'w', encoding='utf-8') as outfile:
    json.dump(combined_data, outfile, ensure_ascii=False, indent=4)
 인코딩 오류 주의
한글로 된 파일이기 때문에 글자들이 깨져서 들어가게 된다
때문에 json 파일을 열거나 저장할 때 꼭 encoding='utf-8' 을 넣어야한다!

코드를 실행 후 전처리한 data_processing1.json 파일이 생성되면 잘 실행된 것이다!
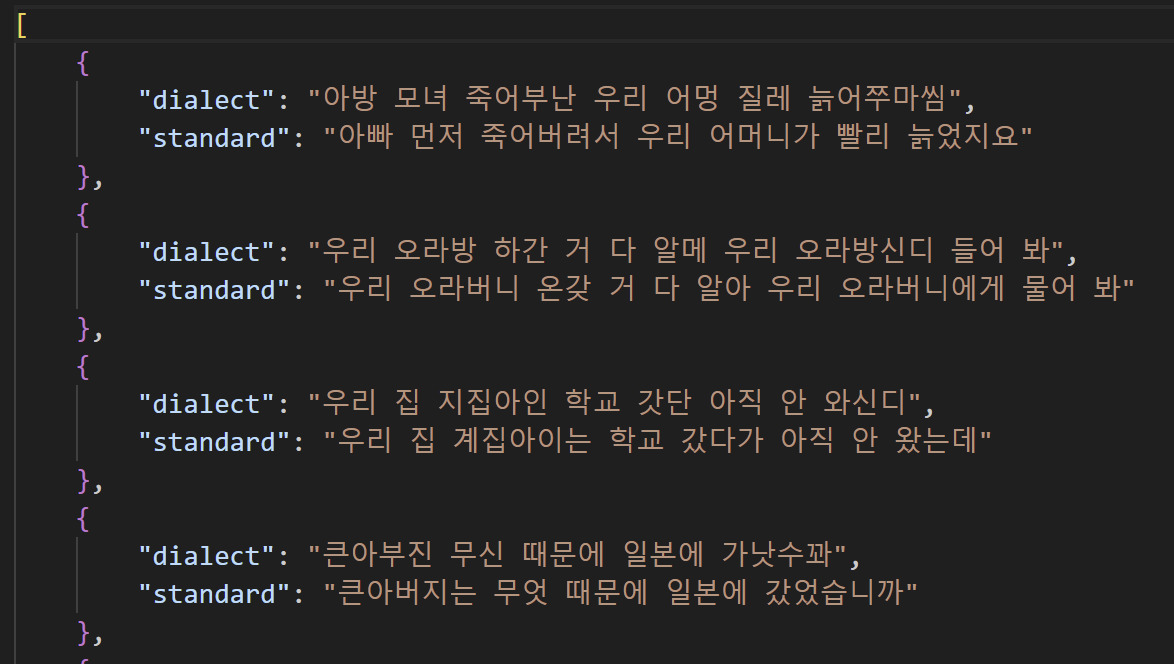
전처리 결과:
2. KoAlpaca finetuning
코랩에서 KoAlpaca 모델을 돌려볼 수 있다! 아래 링크를 들어가서 코랩에서 코드를 돌려보자
https://github.com/Beomi/KoAlpaca
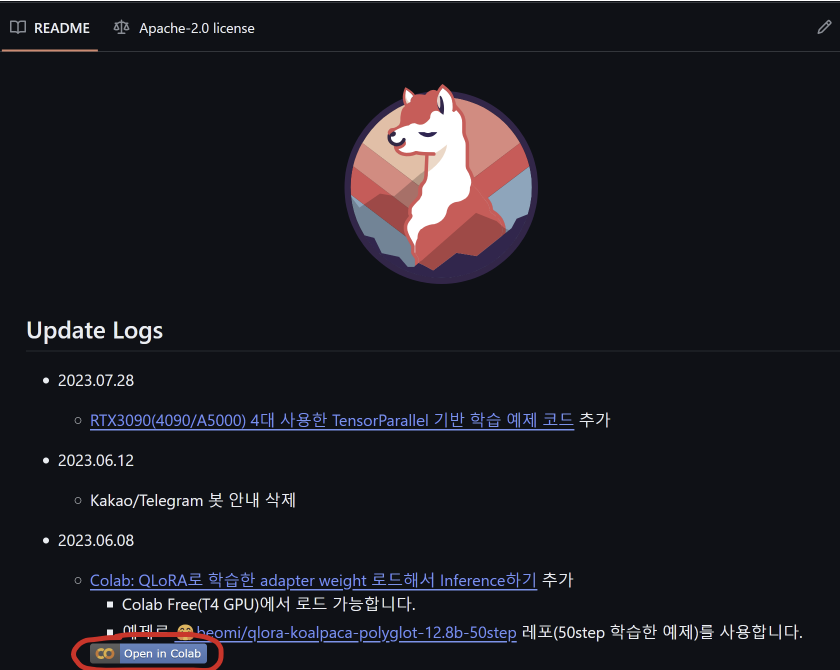
사진에 있는 Open in colab 버튼을 들어가면 코드를 코랩에서 실행시킬 수 있다. 사실 자세한 것은 이해하지 못하지만 최대한 이해해본다.. 
사실 이미 코드가 다 되어있지만 우리가 하고싶은 것은 사투리를 이해할 수 있도록 해야하기 때문에 코드의 일부분을 수정해야 한다. 때문에 중요한 부분과 수정한 곳만 설명하도록 한다
데이터 불러오기
우선 코랩에서 우리가 전처리한 json 파일을 불러오기 위해서는 ‘마운트’ 라는 것을 한 후 구글 드라이브에 연결하고 경로를 복사해서 파일을 불러올 수 있다
아래 코드는 마우트를 하는 코드:
from google.colab import drive
drive.mount('/content/drive')
자세한 설명은 링크 참조!
https://luvris2.tistory.com/189
파일을 불러올 준비가 됬다면 코드를 실행하여 전처리한 파일을 불러온다.
from datasets import load_dataset

#전처리한 데이터 불러오기, 절대경로 or 상대경로
data = load_dataset("json", "전처리된 파일 경로.json")
이제 사투리 질문을 받을 수있도록 데이터를 변환해 준다. 우리가 불러온 data 를 살펴보면 미리 정의된 사투리(질문)와 표준어(답변)를 가진 구조로 되어있는 것을 확인 할 수 있다.
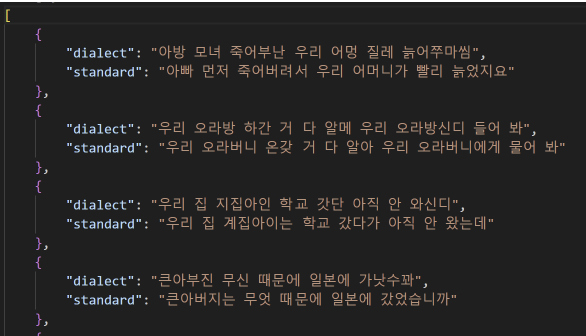
나는 아래와 같은 형식으로 fine-tuning을 진행하고 싶으므로
제주도 사투리를 표준어로 바꿔줘: {제주도 사투리(dialect)}

표준어: {제주도 사투리를 표중러로(standard)}
map 함수를 이용해 주어진 함수(lamda)를 데이터셋의 각 요소에 적용하여 새로운 데이터셋을 생성합니다.
data.map():data라는 변수에 대해map()함수가 호출-
x는 입력 데이터 구조의 각 요소 -
'text'라는 키를 가진 새로운 딕셔너리를 반환 -
'text'에는 내가 지정한 문자열로 값이 저장, x의 dialect 와 standard를 이용해서 구성
data = data.map(
    lambda x: {'text': f"제주도 사투리를 번역해줘: {x['dialect']}\n\n표준어: {x['standard']}<|endoftext|>" }
)
텍스트 데이터 tokenize
data = data.map(lambda samples: tokenizer(samples["text"]), batched=True)
위 코드는 데이터셋의 각 샘플에 대해 텍스트를 토큰화(tokenize)하는 과정을 나타냅니다. 이를 통해 텍스트 데이터를 모델에 입력할 수 있는 형식으로 변환한다.
data.map():data라는 변수에 대해map()함수가 호출,map()함수는 주어진 함수를 데이터셋의 각 요소에 적용하여 새로운 데이터셋을 생성, 여기서는 각 샘플의 텍스트를 토큰화하여 새로운 데이터셋을 생성-
tokenizer: 텍스트를 토큰화하는 역할, 이는 자연어 처리(Natural Language Processing, NLP) 모델을 사용할 때 흔히 사용되는 작업 중 하나로 주어진 텍스트를 토큰(token)이라 불리는 작은 단위로 분할한다. -
batched=True: 데이터를 배치(batch) 형태로 처리하겠다는 옵션, 이 옵션을 사용하면 여러 샘플을 한 번에 처리하여 효율적인 연산을 수행할 수 있다.
토큰화를 왜 하는가??
- 텍스트를 이해 가능한 단위로 분할: 자연어 처리 모델은 단어, 구두점, 숫자 등을 처리할 수 있는 이해 가능한 단위로 텍스트를 분할해야 한다. 토큰화를 통해서 이러한 단위로 텍스트를 분할 하여 모델이 이해할 수 있는 형태로 만들어야 한다.
- 텍스트를 숫자로 변환: 대부분의 딥러닝 모델을 텍스트 데이트를 그냥 입력으로 받아드리는 것이 아니라 숫자 데이터 를 입력으로 받는다. 때문에 텍스트를 숫자로 변환하는 과정이 필요하다. 토큰화를 통해서 텍스트를 숫자 형태로 변환하여 모델에 입력할 수 있도록 해야한다.
- 텍스트의 특성을 보존: 토큰화는 단어의 순서, 문법적 구조, 의미 등을 보존하면서 텍스트를 분할, 텍스트가 원본 텍스트의 의미를 최대한 유지하도록 한다.
- 모델의 입력 크기를 조절: 텍스트의 길이가 다양지만 모델은 고정된 크기의 입력을 필요로 하는 경우가 많다. 토큰화를 통해 텍스트의 길이를 조절하여 모델에 입력할 수 있는 크기로 변환할 수 있다.
모델이 받아들일 수 있는 형식으로 변환하고 텍스트를 이해할 수 있도록 분할하는 역할을 한다!
이제 모델에게 질문을 해서 새로운 텍스트를 생성할 수 있도록 하는 함수를 정의 한다.
def gen(x):
    gened = model.generate(
        **tokenizer(
            f"제주도 사투리를 번역해줘: {x}\n\n표준어:",
            return_tensors='pt',
            return_token_type_ids=False
        ),
        max_new_tokens=256,
        early_stopping=True,
        do_sample=True,
        eos_token_id=2,
    )
    print(tokenizer.decode(gened[0]))
-
generate(): 모델을 사용하여 주어진 입력에 대해 새로운 텍스트를 생성, 이 함수는 OpenAI GPT와 같은 딥러닝 언어 모델에서 일반적으로 사용됩니다. -
tokenizer(): 주어진 텍스트를 모델이 이해할 수 있는 형식으로 변환, 이는 토큰화 및 텍스트를 숫자로 변환하는 작업을 포함할 수 있습니다. -
max_new_tokens: 생성할 새로운 토큰의 최대 개수를 지정, 이 매개변수는 모델이 최대 몇 개의 새로운 토큰을 생성할지를 결정합니다. -
do_sample: 샘플링 방법을 지정, 이 매개변수가 True로 설정되면 모델은 생성된 텍스트를 샘플링하여 다양한 텍스트를 생성할 수 있습니다. -
eos_token_id: 생성된 텍스트의 종료 토큰(end-of-sequence token)을 지정, 이 매개변수는 생성된 텍스트의 끝을 나타내는 특정 토큰의 ID를 지정 -
print()함수는 생성된 텍스트를 콘솔에 출력
설명한 부분의 코드만 수정되었고 나머지는 동일하다.
코드가 오류 없이 모두 잘 실행된다면 아래와 같은 형식으로 질문을 하면 모델이 사투리를 표준어로 바꾸어주는 답 잘 생성해 낸다면 성공!
gen('제주도 사투리')